Biologie · Première · 17 min de lecture
Du gène à la protéine : transcription et traduction
Du gène à la protéine : transcription en ARN messager, code génétique (codons, redondance, universalité), traduction par le ribosome, relation génotype-phénotype.
Chapitre du programme : Transmission, variation et expression du patrimoine génétique
Bloc 1 sur 7 · Comprendre
Comprendre : un gène est un texte, la protéine sa traduction
Depuis la troisième, tu sais qu'un gène « détermine » un caractère. La leçon précédente a montré comment l'ADN se copie. Reste la question centrale de la génétique : comment une séquence de nucléotides, enfermée dans le noyau, produit-elle quelque chose dans la cellule ? La réponse tient en un flux à deux étapes, que tous les êtres vivants partagent.
Un gène est une portion d'ADN qui code une protéine — parfois plusieurs, on verra pourquoi. Son information est d'abord transcrite en une copie mobile, l'ARN messager, puis cette copie est traduite en une chaîne d'acides aminés — la protéine. ADN → ARN messager → protéine.
Étape 1 — la transcription : copier le gène en ARN. Dans le noyau, une enzyme, l'ARN polymérase, ouvre localement la double hélice au niveau du gène et lit un seul des deux brins, appelé brin transcrit. En face de chaque nucléotide de ce brin, elle place le nucléotide complémentaire — avec une différence : l'ARN n'a pas de thymine, il a de l'uracile (U). Ainsi : en face d'un A elle place un U, en face d'un T un A, en face d'un C un G, en face d'un G un C. Le produit est un ARN messager (ARNm), simple brin, court, qui quitte le noyau. L'autre brin d'ADN, non lu, est appelé brin codant : il a la même séquence que l'ARNm, à T contre U près.
Étape 2 — la traduction : lire l'ARN par triplets. Dans le cytoplasme, un ribosome parcourt l'ARNm et le lit trois nucléotides par trois nucléotides. Chaque triplet est un codon, et à chaque codon correspond un acide aminé, que le ribosome ajoute à la chaîne en cours. La correspondance codon → acide aminé est le code génétique. La lecture commence au codon d'initiation AUG (qui code la méthionine) et s'arrête au premier codon stop (UAA, UAG ou UGA), qui ne code aucun acide aminé.
Pourquoi des triplets ? Il y a nucléotides et acides aminés à désigner. Avec des mots de deux lettres, on n'aurait que mots : pas assez. Avec trois lettres, mots : largement assez. Le code est donc redondant (on dit aussi dégénéré) : plusieurs codons désignent le même acide aminé — la phénylalanine est codée par UUU et par UUC. Mais il n'est jamais ambigu : un codon donné désigne toujours le même acide aminé. Et il est universel : le même code sert à la bactérie, au blé et à l'être humain — c'est ce qui rend possible la transgenèse évoquée en seconde.
Ce que le gène ne code pas. Un gène code une protéine, pas un caractère. Le caractère — la couleur des yeux, un groupe sanguin, une maladie — est le résultat de l'action de cette protéine, souvent combinée à celle d'autres protéines et à l'environnement. Le phénotype se lit à trois échelles : moléculaire (la protéine), cellulaire (ce que la cellule fait ou ne fait pas), macroscopique (l'organisme). Le génotype, lui, est l'ensemble des allèles. Cette distinction commande toute la leçon sur les mutations.
Bloc 2 sur 7 · Approfondir
Approfondir : lire le code, choisir le bon brin
Le code génétique est toujours donné. Personne ne t'en demandera la mémorisation : en devoir comme dans les exercices, un extrait du tableau des codons est fourni. Ce qu'on attend de toi, c'est de savoir l'utiliser : partir de l'ARNm, le découper par triplets à partir du codon d'initiation, lire chaque codon dans la table, s'arrêter au stop. Trois pièges de lecture reviennent sans cesse — chacun a son bloc plus bas.
Brin transcrit ou brin codant : la convention est dans l'énoncé. Un fragment d'ADN présenté seul ne dit pas quel brin il est. Un énoncé honnête le précise, et tu dois lire cette précision avant tout calcul. Si l'on te donne le brin transcrit, l'ARNm est son complémentaire avec U : , , , . Si l'on te donne le brin codant, l'ARNm est sa copie où chaque T devient U. Les deux chemins mènent au même ARNm — celui du gène —, mais les appliquer au mauvais brin donne une séquence qui n'a rien à voir.
Comment le code a été déchiffré. En 1961, Marshall Nirenberg et Heinrich Matthaei fournissent à un extrait de bactéries un ARN artificiel fait uniquement d'uracile : UUUUUU… Le système fabrique une chaîne faite uniquement de phénylalanine. Premier mot du code décrypté : UUU code la phénylalanine. En quelques années, des ARN de composition contrôlée ont livré les correspondances. Retiens la logique : on impose la séquence, on observe la protéine, on en déduit le dictionnaire.
Redondance et sécurité. Que codons sens désignent acides aminés n'est pas une bizarrerie : c'est une protection. Les codons synonymes diffèrent souvent par leur troisième lettre (UUU et UUC, CCU, CCC, CCA et CCG) : une erreur à cette position change le codon sans changer l'acide aminé. La leçon sur les mutations en fera une catégorie à part entière, les mutations silencieuses.
Compter juste. Un ARNm de nucléotides lu depuis sa première base contient codons. Le peptide traduit contient autant d'acides aminés que de codons avant le premier stop — le stop lui-même ne compte pas, et ce qui le suit n'est pas lu. Le codon AUG initial compte : la méthionine est le premier acide aminé de la chaîne. Trois erreurs classiques dans un même dénombrement : compter le stop, continuer après lui, oublier la méthionine.
Chez les eucaryotes, une étape de plus. Chez les cellules à noyau, l'ARN produit par la transcription — l'ARN pré-messager — subit une maturation avant de quitter le noyau : il est épissé, c'est-à-dire que certaines portions (les introns) sont retirées et que les portions conservées (les exons) sont raboutées. Selon les portions conservées, un même gène peut donner plusieurs ARN messagers différents, donc plusieurs protéines : c'est l'épissage alternatif, et c'est pourquoi « un gène, une protéine » doit se lire « un gène, une ou plusieurs protéines ». L'ARNm lu par le ribosome n'est donc pas toujours la copie intégrale du gène.
Du génotype au phénotype, avec l'environnement. Une protéine peut être une enzyme (la prochaine leçon de la progression), un transporteur, un récepteur, un élément de structure. Prends l'albinisme : un allèle muté du gène de la tyrosinase donne une enzyme inactive (phénotype moléculaire) ; les cellules pigmentaires ne fabriquent plus de mélanine (phénotype cellulaire) ; peau, cheveux et yeux sont dépigmentés (phénotype macroscopique). Un gène, une protéine — et un caractère qui découle de la chaîne entière. Ajoute l'environnement : l'exposition au soleil module le bronzage de la plupart d'entre nous, pas le génotype. Génotype et environnement fabriquent ensemble le phénotype.
Bloc 3 sur 7 · Exemple
Exemple guidé : transcrire, puis traduire un fragment
Énoncé. On donne le brin transcrit d'un fragment de gène, lu de gauche à droite :
T – A – C – A – A – A – G – G – C – A – T – T
Extrait du code génétique (codon d'ARNm → acide aminé) :
| Codon | AUG | UUU | UUC | CCG | CCA | UAC | UAA |
|---|---|---|---|---|---|---|---|
| Acide aminé | Méthionine | Phénylalanine | Phénylalanine | Proline | Proline | Tyrosine | stop |
- Écrire la séquence de l'ARN messager transcrit.
- Écrire le brin codant de ce fragment.
- Découper l'ARNm en codons et donner le peptide traduit. Combien d'acides aminés contient-il ?
- Quelle serait la « traduction » si l'on avait pris le brin donné pour le brin codant ? Conclure.
---
1. Transcrire le brin transcrit. On remplace chaque base par sa complémentaire, T devenant A et A devenant U :
T → A, A → U, C → G, A → U, A → U, A → U, G → C, G → C, C → G, A → U, T → A, T → A.
ARNm : A – U – G – U – U – U – C – C – G – U – A – A.
2. Le brin codant. C'est le complémentaire du brin transcrit, dans l'ADN cette fois (T, pas U) : A – T – G – T – T – T – C – C – G – T – A – A. Vérification : c'est bien l'ARNm avec U remplacé par T. Les deux brins racontent la même chose, l'un en positif, l'autre en négatif.
3. Traduire. Douze nucléotides, donc
Lecture dans la table : AUG → méthionine (le codon d'initiation, il compte) ; UUU → phénylalanine ; CCG → proline ; UAA → stop, la traduction s'arrête. Peptide : méthionine – phénylalanine – proline, soit acides aminés pour codons. Le codon stop n'ajoute rien.
4. Le mauvais brin. Si l'on prenait le brin donné pour le brin codant, l'ARNm serait sa copie avec U : U – A – C – A – A – A – G – G – C – A – U – U, soit les codons UAC (tyrosine), AAA, GGC, AUU — sans AUG initial, sans stop, et deux codons absents de l'extrait fourni. Rien ne colle : la nature du brin n'est pas un détail, elle décide de tout.
Contrôle. Deux vérifications rapides : l'ARNm ne contient aucun T, et il commence par AUG. Si l'un des deux manque, la transcription ou le choix du brin est à reprendre.
Bloc 4 sur 7 · Visualiser
Visualiser : le flux de l'information génétique
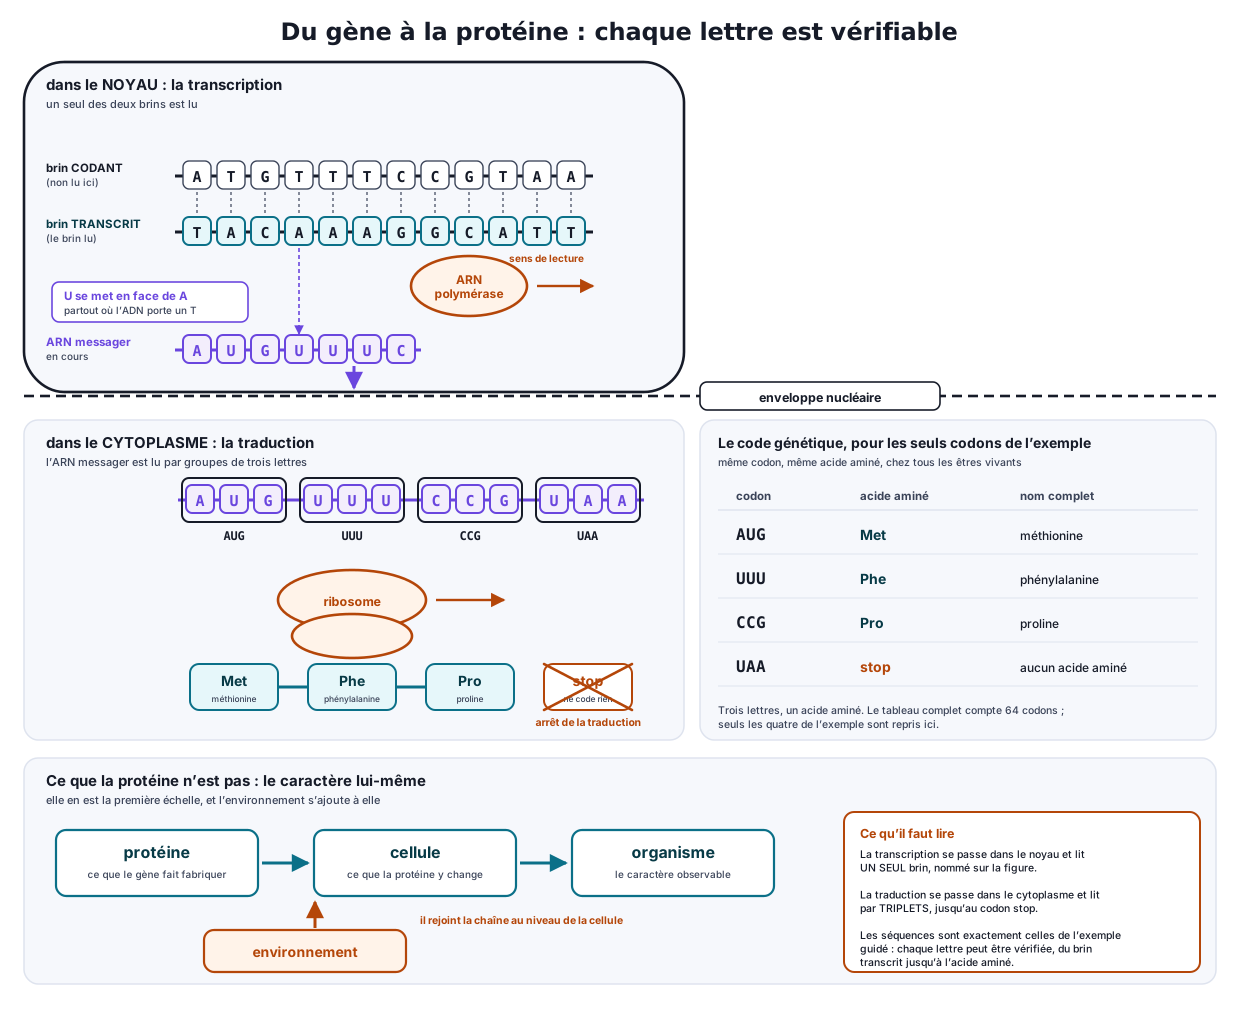
Figure (fig.biology.gene-expression-flow, SVG programmatique à produire) : un schéma en trois étages, de haut en bas, séparé par une ligne « enveloppe nucléaire ».
- Étage du haut — l'ADN dans le noyau. Un fragment de double hélice déroulé en deux lignes parallèles, portant les séquences de l'exemple guidé : le brin transcrit en bas (T A C A A A G G C A T T), le brin codant en haut (A T G T T T C C G T A A). Les deux brins sont nommés en toutes lettres. Une ARN polymérase, dessinée comme une forme arrondie, est posée sur le brin transcrit ; derrière elle, l'ARNm en cours d'assemblage, en simple brin, avec la mention « U en face de A ».
- Ligne médiane : l'enveloppe nucléaire en pointillé, franchie par une flèche portant l'ARNm complet : A U G U U U C C G U A A, découpé en quatre cases de trois lettres.
- Étage du bas — le cytoplasme. Un ribosome (deux formes arrondies emboîtées) avance sur l'ARNm ; sous lui, quatre cases alignées avec les codons : « Met », « Phe », « Pro », « stop », les trois premières reliées en chaîne, la dernière barrée avec la mention « ne code rien : arrêt ». Un extrait du code génétique en tableau miniature figure dans un encart, avec les seuls codons de l'exemple.
- Bandeau du bas : les trois échelles du phénotype, en trois cases reliées par des flèches : « protéine » → « cellule » → « organisme », avec, en parallèle, une flèche « environnement » qui rejoint la chaîne au niveau de la cellule.
Ce qu'il faut lire. Le schéma sépare ce qui se passe dans le noyau (la transcription lit un seul brin, nommé) de ce qui se passe dans le cytoplasme (la traduction lit par triplets, s'arrête au stop). Les séquences sont exactement celles de l'exemple : on peut vérifier chaque lettre. Le bandeau rappelle que la protéine n'est pas le caractère : elle en est la première échelle.
La figure en détail : la figure est organisée en trois bandes horizontales. En haut, à l'intérieur du noyau, un fragment d'ADN est représenté par deux lignes de lettres superposées, la ligne du bas étant nommée brin transcrit et la ligne du haut brin codant. Une forme arrondie, l'ARN polymérase, est posée sur le brin transcrit ; elle laisse derrière elle une ligne unique de lettres, l'ARN messager, où la lettre U apparaît en face de chaque A. Au milieu, une ligne pointillée figure l'enveloppe du noyau ; l'ARN messager complet la traverse, découpé en groupes de trois lettres : AUG, UUU, CCG, UAA. En bas, dans le cytoplasme, un ribosome dessiné comme deux formes emboîtées avance sur l'ARN messager ; sous chaque groupe de trois lettres est écrit l'acide aminé correspondant, méthionine, phénylalanine, proline, puis la mention stop pour le dernier groupe, qui n'ajoute rien à la chaîne. Un petit tableau rappelle la correspondance entre ces codons et ces acides aminés. Tout en bas, trois cases reliées par des flèches, protéine, cellule, organisme, illustrent les trois échelles du phénotype, une flèche supplémentaire nommée environnement rejoignant la chaîne au niveau de la cellule.
Bloc 5 sur 7 · Formules
Ce qu'il faut retenir
| Relation ou règle | Énoncé | Domaine de validité |
|---|---|---|
| Transcription | un seul brin lu (le brin transcrit) ; complémentarité avec U à la place de T | dans le noyau, gène par gène, à la demande |
| Brin codant | même séquence que l'ARNm, T au lieu de U | convention à lire dans l'énoncé |
| Code génétique | codons, acides aminés ; redondant, non ambigu, universel | tous les êtres vivants (à de rares variantes près) |
| Bornes de lecture | départ au codon AUG (méthionine), arrêt au premier stop UAA, UAG, UGA | le stop ne code aucun acide aminé |
| Dénombrement | nucléotides → codons ; acides aminés = codons avant le stop, AUG compris | ARNm lu depuis sa première base |
| Génotype → phénotype | un gène code une ou plusieurs protéines ; le caractère résulte des protéines et de l'environnement | phénotype moléculaire, cellulaire, macroscopique |
Les mots. Codon : triplet de nucléotides de l'ARNm. Codons synonymes : codons différents qui désignent le même acide aminé (redondance). Brin transcrit : celui que l'ARN polymérase lit. Brin codant : l'autre. Ribosome : la particule qui lit l'ARNm et assemble les acides aminés.
Où cela mène. La leçon sur les mutations utilise exactement ces règles pour calculer l'effet d'un changement de séquence sur la protéine ; la leçon sur les enzymes montre ce que fait la protéine une fois produite.
Bloc 6 sur 7 · Pièges
Pièges fréquents
- Lire le brin codant comme s'il était le brin transcrit — ou l'inverse. Le brin transcrit donne l'ARNm par complémentarité ; le brin codant le donne par copie. Appliquer la complémentarité au brin codant produit une séquence sans rapport avec le gène. Lis d'abord la nature du brin dans l'énoncé.
- Écrire un T dans l'ARN. L'ARN contient de l'uracile : en face d'un A du brin transcrit, un U. Un ARNm qui contient un T est faux d'office — c'est la première vérification à faire.
- Continuer la traduction après un codon stop. UAA, UAG et UGA arrêtent la lecture ; ce qui suit n'est pas traduit, même s'il y a encore des codons. Un peptide « plus long que le stop » n'existe pas.
- Compter le codon stop comme un acide aminé. Il ne code rien. Quatre codons dont un stop donnent trois acides aminés, pas quatre.
- Oublier la méthionine initiale, ou démarrer ailleurs qu'à AUG. Le codon d'initiation est traduit : la méthionine est le premier acide aminé. Et le découpage en triplets commence à AUG — décaler d'une lettre change tous les codons.
- Croire qu'un gène code un caractère complet. Il code une protéine. Le caractère est un phénotype d'échelle supérieure, produit par une ou plusieurs protéines et par l'environnement. « Le gène de la couleur des yeux » est une façon de parler, pas une description.
- Prendre la redondance pour une ambiguïté. Plusieurs codons peuvent désigner le même acide aminé (redondance) ; un codon ne désigne jamais deux acides aminés (non-ambiguïté). Le dictionnaire a des synonymes, pas des homonymes.
- Confondre transcription et réplication. La transcription copie un gène en ARN, à tout moment du cycle ; la réplication copie tout l'ADN en ADN, en phase S. Produit différent, étendue différente, moment différent.
Bloc 7 sur 7 · Vérifier
Vérifier : transcrire un brin dont la nature est donnée
Le modèle d'entraînement. L'exercice associé à cette leçon affiche un fragment d'ADN de à nucléotides et écrit sa nature — brin transcrit ou brin codant, à parts égales — puis demande la séquence de l'ARN messager parmi quatre propositions de même longueur : la bonne, le complémentaire écrit avec T, la copie brute avec T, et la lecture du mauvais brin. Un modèle voisin donne un ARNm lu depuis AUG et un extrait du code génétique, et demande le nombre d'acides aminés du peptide (avec un stop interne une fois sur deux), l'acide aminé de rang , ou si un gène code un caractère.
Énoncé type. Voici un fragment du brin transcrit d'un gène, lu de gauche à droite : T – A – C – G – G – A – T – T – C. Quelle est la séquence de l'ARN messager transcrit, lue dans le même ordre ?
Corrigé complet.
1. Lire la nature du brin. C'est le brin transcrit, celui que l'ARN polymérase lit : l'ARNm est son complémentaire, avec U à la place de T.
2. Appliquer la complémentarité, base par base. T → A ; A → U ; C → G ; G → C ; G → C ; A → U ; T → A ; T → A ; C → G.
3. Écrire et vérifier.
ARNm : A – U – G – C – C – U – A – A – G.
Aucun T, longueur conservée ( nucléotides), et un AUG en tête : trois signes que la transcription est correcte.
4. Écarter les mauvaises réponses. « A – T – G – C – C – T – A – A – G » est le brin codant de l'ADN, pas un ARN : il contient des T. « U – A – C – G – G – A – U – U – C » est la copie du brin donné avec U : c'est ce qu'on obtiendrait si le brin était codant — il ne l'est pas. Toute séquence de longueur différente est exclue : la transcription ne change pas la longueur.
Auto-contrôle. Ai-je lu la nature du brin avant de choisir entre complémentarité et copie ? Mon ARNm est-il sans T ? A-t-il la même longueur que le fragment ? Ces trois questions éliminent la quasi-totalité des erreurs de ce modèle.
Sources
- BO spécial n°1 du 22 janvier 2019 — programme de spécialité sciences de la vie et de la Terre de première générale, thème « La Terre, la vie et l'organisation du vivant » : transmission, variation et expression du patrimoine génétique — l'expression du patrimoine génétique
- B. Alberts et al., Biologie moléculaire de la cellule, Lavoisier — chapitre « De l'ADN à la protéine » (transcription, code génétique, traduction)
- M. W. Nirenberg, J. H. Matthaei, « The dependence of cell-free protein synthesis in E. coli upon naturally occurring or synthetic polyribonucleotides », Proceedings of the National Academy of Sciences, vol. 47, 1961, p. 1588-1602
Continuer
Autres leçons — Biologie
- Le croisement monohybride : prévoir la descendance pour un gène
- Chromosomes et caryotype : l'information génétique rangée par paires
- Gènes et allèles : pourquoi deux individus ne se ressemblent pas
- Reproduction sexuée : comment les chromosomes passent d'une génération à l'autre
- Arbres phylogénétiques : lire la parenté entre les espèces
- Le système nerveux : capter, décider, commander
- La communication hormonale : un message porté par le sang
- Observer au microscope
- La cellule, unité du vivant
- Classification emboîtée du vivant
- Écosystèmes et réseaux trophiques
- Digestion et nutriments
- Respiration et échanges gazeux
- La circulation sanguine
- La cellule eucaryote : des compartiments spécialisés
- L'ADN : une double hélice porteuse d'information
- La sélection naturelle : un tri sans intention
- La dérive génétique : quand le hasard seul fait évoluer
- La biodiversité : trois échelles sous pression
- Cycle cellulaire et mitose : copier, puis répartir
- La réplication de l'ADN : une copie semi-conservative
- Les mutations : quand la copie change le texte
- Les enzymes : des protéines qui catalysent
- L'immunité adaptative : spécifique, amplifiée, mémorisée
- La méiose : diviser par deux, et brasser
- Deux gènes à la fois : indépendants ou liés ?
- L'équilibre de Hardy-Weinberg : le modèle de référence
- Le potentiel d'action : un message tout ou rien
- La régulation de la glycémie
- Contraction musculaire et énergie
- La photosynthèse : de la lumière à la matière
- La respiration cellulaire et l'ATP
- Le cycle du carbone
- L’immunité innée : une première défense immédiate
- Cinétique michaélienne et inhibitions enzymatiques
- La vaccination : préparer la mémoire immunitaire
- Acides aminés : ionisation, zwitterion, point isoélectrique
- Échanges membranaires : diffusion, osmose, transport actif
- La PCR : copier des millions de fois une région choisie